专题 13 / 完整阅读
JVM内存结构与OOM排查实战
技术基线:64 位 HotSpot JDK 8,以 Linux / Docker / Kubernetes 服务为例;在末尾说明 JDK 11/17+ 的主要差别。 内容范围:通过 23 张可缩放 SVG 图(结构图、流程图、内存趋势图)、诊断命令、判读逻辑、典型生产案例和应急清单,梳理 JVM 内存与 OOM 排查。 核心认识:Java 进程内存 ≠ Java 堆;OOM ≠ 一定有内存泄漏;排查要先识别“哪一种内存”出了问题。
1. 开场:我们究竟要排查什么
先从三个常见问题入手:
- Java 应用的
-Xmx配成 3G,容器限制 4G,为什么还会被OOMKilled? - GC 已经执行过很多次,为什么还会报
java.lang.OutOfMemoryError: Java heap space? - Heap Dump 看着没问题,为什么网关进程 RSS 一直涨,甚至出现
OutOfDirectMemoryError?
这三个问题能直接暴露一个常见误区:把 JVM 运行时内存、HotSpot 原生内存、操作系统实际驻留内存混成了一个概念。
分析要点: -Xmx 只约束 Java 堆上限,并不等于进程内存上限。Metaspace、线程栈、Direct Buffer、Code Cache、JVM 自身的 GC 数据结构、JNI 分配等,也需要资源。图中的 RSS 只是为了说明不同来源都可能影响进程驻留量;真实 RSS 与各分项之间可能有共享页、已保留但未提交、已提交但未驻留等差异,不能直接算术相加。
1.1 先区分三个指标
| 指标 | 含义 | 常见误区 |
|---|---|---|
reserved |
保留的虚拟地址空间 | 保留 ≠ 实际使用了物理内存 |
committed |
已提交、可供使用的虚拟内存 | 提交 ≠ 该时刻全部页都驻留在 RSS |
RSS |
进程实际驻留物理页规模 | RSS ≠ 堆已使用,也不等同于容器全部内存用量 |
在容器中还需要区分 进程 RSS、memory.current / cgroup 使用量和内存限制。容器内存账单可能包含其下进程、文件页缓存等,具体由 cgroup 版本与统计口径决定。
2. JVM 内存结构总览
2.1 先看规范,再看 HotSpot 实现
线程共享:
- Java Heap(堆):主要存放普通对象和数组,GC 的核心管理对象。这里说的是“主要”,因为逃逸分析、标量替换、JIT 优化可能使部分对象分配被消除。
- 方法区(Method Area):JVM 规范中的逻辑概念,包含类型信息、运行时常量池等。HotSpot JDK 8 用 Metaspace 等机制实现类元数据存储,不要把“方法区”与某一个具体物理内存块完全画等号。
- 运行时常量池:与类关联的常量、符号引用等;不要与
String.intern()的字符串实例存放位置混为一谈。JDK 7 起 HotSpot 的字符串常量池相关对象已主要置于 Java 堆。
线程私有:
- 程序计数器:跟踪线程字节码执行位置。
- Java 虚拟机栈:每一次方法调用都会压入栈帧,方法完成后栈帧弹出。
- 本地方法栈:支持 native 方法调用;HotSpot 的实现细节并非必须与 Java 栈形成两个独立物理存储区。
规范之外但故障时尤其关键: Direct Buffer、JNI/native malloc、Code Cache、线程实际栈内存、内存映射、分配器缓存等。
2.2 栈帧里放什么?“对象都在栈上”对不对?
考虑以下代码:
public void foo(int id) {
    User user = new User();
    user.setId(id);
    consume(user);
}
id、局部变量 user(对象引用)可以存在当前栈帧局部变量表中,而 new User() 通常在堆上分配。user 是一个引用变量,不是把整个 User 实例放进了栈帧。JIT 可能进一步优化,因此不要用源代码中的 new 数量直接等价于最终堆分配量。
容易混淆的问题:
StackOverflowError:通常是调用深度、递归或栈空间问题;它不是堆 OOM。OutOfMemoryError: unable to create new native thread:通常属于无法再为线程创建本地资源,不代表某个 Java 栈帧“装满了”。- 静态变量存什么? 静态字段的值可能是对象引用;所引用的普通对象仍可在 Heap 上,其所属类的元数据另由类加载系统管理。
2.3 一个普通对象在 HotSpot 里大致长什么样
以常见 HotSpot 对象为例,可分为:对象头、实例字段、对齐填充。对象头包含 Mark Word 和类型指针等信息;数组对象还会包含数组长度。对象真实大小取决于 32/64 位、压缩指针、字段布局、对齐参数及 JDK 版本,不要把图里的分区比例当成固定字节数。
这张图的价值在于解释:为什么 Heap Dump 能看到上百万个 User、byte[],而 Metaspace 追踪的是 User 这样的类型元数据,不是 100 万份 User 实例的全部内容。
2.4 JDK 8 的 PermGen / Metaspace 到底变了什么
| 维度 | JDK 7 及更早的典型 HotSpot | JDK 8 HotSpot |
|---|---|---|
| 类元数据主要存储 | 永久代 PermGen | 原生内存中的 Metaspace |
| 典型上限参数 | -XX:MaxPermSize |
-XX:MaxMetaspaceSize |
| OOM 文本 | PermGen space |
Metaspace、Compressed class space |
| 容易犯的错 | 认为 PermGen 就是规范的方法区本身 | 认为元空间无限、也不受容器内存约束 |
结论: 移除了 PermGen 不是“类不会引发 OOM”,只是换了一套内存分配与管理机制。
3. 堆中的对象如何诞生、存活和死亡
3.1 传统分代结构:Eden / Survivor / Old
教学时分成三步:
- 分配:绝大多数新生对象优先进入 Eden,线程可能使用 TLAB(Thread Local Allocation Buffer)来降低分配竞争。
- Young / Minor GC:Eden 和存活的 Survivor 对象参与回收,存活对象复制到目标 Survivor 或晋升 Old。
- 晋升:年龄达到阈值、目标 Survivor 容量不足等情况,都可能影响晋升。不是“对象恰好经历 15 次 GC 才会进老年代”。
TLAB 是什么
TLAB 在 Java Heap 里面,不是 Direct Memory,也不是额外新增的一块内存区域。线程在 Eden 内领用小块独占分配缓冲区,便于通过指针碰撞快速分配对象。TLAB 用尽走慢路径,可能申请新 TLAB 或按分配策略处理。
3.2 new 发生时,并不必然先触发 GC
这是一张教学用近似决策图,不是 HotSpot 某个版本的精确源码控制流:
- 优先走当前线程的快速分配路径;失败后尝试更慢的分配路径。
- 分配器、GC 策略、是否大对象、是否需要晋升,决定后续行为。
- 如果最终无法满足堆内分配,才会出现
Java heap space。 - 对 G1 而言,Humongous 对象走特殊路径,不能机械套用上面传统 Eden → Survivor 的路径。
3.3 G1 的 Region:不是每个 Region 里都含 Eden + Survivor + Old
重点要讲清楚: G1 将整个 Heap 划成多个等大小 Region,每个 Region 在某个时刻对应一个角色(Eden、Survivor、Old、Free 或 Humongous 等),不是在单个 Region 里面再划出一小块 Eden、一小块 Survivor 和 Old。
- Region 大小通常为 1MB—32MB 的 2 次幂,由 JVM 结合堆规模选择,也可以检查
-XX:G1HeapRegionSize。 - 多个 Eden Region 不需要彼此连续;Old Region 也不必是堆末尾的一大片连续物理空间。
- Humongous:大小达到或超过 Region 一半的对象在 G1 中走特殊分配路径,可能需要多个连续 Region。大型
byte[]、压缩包、整包响应等场景值得注意。 - 图上 20 个 Region 只是帮助理解,真实 Region 数量通常更多。
讨论题: “G1 有没有年轻代和老年代?”——有,是逻辑上的 Region 集合,不是必须连续的两大物理区。
3.4 对象什么时候才会被回收?看 GC Roots
判断一个对象是否还活着,不取决于“业务还需不需要它”,而取决于它是否从 GC Roots 可达。常见根包括线程活动栈帧中的引用、静态字段可达链、JNI 引用、JVM 内部根等。
private static final Map<String, byte[]> CACHE = new ConcurrentHashMap<>();

public void handle(String key) {
    CACHE.put(key, new byte[1024 * 1024]);
}
即便请求早已结束,只要 CACHE 继续持有这些条目,就不会因为“这个请求完成了”而自动回收。与此相对,只有短生命周期大对象导致的瞬时高水位,不一定是内存泄漏。
3.5 强、软、弱、虚引用有什么区别
| 类型 | 典型场景 | 回收理解 |
|---|---|---|
| 强引用 | 正常字段、集合成员 | 根可达时通常不会被回收 |
SoftReference |
某些缓存策略 | 内存压力下可能清理;不可当成可靠缓存淘汰方案 |
WeakReference |
不阻止回收的索引、映射 | 仅弱可达对象在 GC 中可被清理 |
PhantomReference |
配合 ReferenceQueue 做资源生命周期跟踪 |
get() 不提供被引用对象;不等于直接释放 native 资源 |
Netty 补充: ByteBuf 的释放由引用计数决定;垃圾回收并不自动保证池化 ByteBuf 被正确归还。
4. GC:为什么回收之后还会 OOM
4.1 先理解四个术语
| 术语 | 重点 |
|---|---|
| Young / Minor GC | 主要收集年轻代,不是全堆扫描的同义词 |
| Mixed GC | G1 收集年轻代,并选取部分 Old Region 一起回收 |
| Full GC | 通常涉及全堆级别的停顿和回收;不同收集器的触发及行为不同 |
| STW(Stop The World) | 应用线程因 GC 的某些阶段暂停;并发标记不意味着全过程零 STW |
4.2 G1 的典型周期
图中先后顺序展示的是一次典型标记/回收周期,而不是每轮 Young GC 都必然马上开始一次标记。G1 通常经历:
- 多次 Young GC,部分对象晋升 Old。
- 达到条件后,以一次 Young GC 搭载 Initial Mark(STW)。
- Root Region Scan 与 Concurrent Mark:可与应用线程并发(期间仍可能有 Young GC)。
- Remark(STW)与 Cleanup:完成存活性判断、统计候选 Region。
- 如果收益足够,开始若干轮 Mixed GC,回收 Young + 部分 Old;之后再回到 Young-only 阶段。
两条常见错误说法:
- “G1 是并发 GC,所以不会 STW”——错误。Young / Mixed 的 Evacuation Pause 等阶段需要 STW。
- “Mixed GC 就是 Full GC”——错误。Mixed 只选部分老年代 Region,Full GC 有不同的触发机制和代价。
4.3 从一段 GC 日志里到底看什么
下面是示意日志,非真实生产截取:
2026-10-14T10:00:00.000+0800: 120.000: [GC pause (G1 Evacuation Pause) (young)
  4096M->2850M(6144M), 0.083 secs]
2026-10-14T10:01:00.000+0800: 180.000: [GC pause (G1 Evacuation Pause) (mixed)
  5300M->4220M(6144M), 0.211 secs]
2026-10-14T10:03:00.000+0800: 300.000: [Full GC ...
  6100M->5780M(6144M), 8.200 secs]
读法:回收前占用 -> 回收后占用 (堆容量),后面是停顿时间。生产日志格式受 JDK 版本、垃圾回收器和 JVM flag 影响;不要把上面格式当成唯一格式。
重点看三项:
- GC 后基线:回收后还剩多少?长期持续抬升比“瞬时占用冲高”更值得警惕。
- 回收效率:回收前后下降了多少?Full GC 后几乎不降,提示存活对象确实多或回收条件不利。
- 暂停时间与频率:是偶发长暂停,还是短时间持续 GC 抢走 CPU?两者改善措施不同。
4.4 用 jstat 看趋势,而不是只看一次快照
PID=12345
jstat -gcutil "$PID" 1000 10
输出中常见的 S0/S1/E/O/M 表示各区使用比例,YGC/YGCT、FGC/FGCT 是相应 GC 次数与耗时(字段依具体 JDK/收集器而异)。
判读:
O随时间升高,但 Young GC 后不明显下降:不一定异常,因为 Young GC 通常不回收 Old。- 回收老年代之后占用仍持续增加:要判断是业务在积累合理活对象,还是对象引用意外留存。
FGC短期暴涨,且 GC 后老年代使用率不下降:需要优先采集证据并干预。
下面三张曲线是为了帮助理解而生成的示意数据,不是某个真实生产系统的监控截图。观察这些曲线时可以注意:只看瞬时高点,很容易误判;要看 GC 后低点是否上涨,以及 Heap 与 RSS 是否背离。
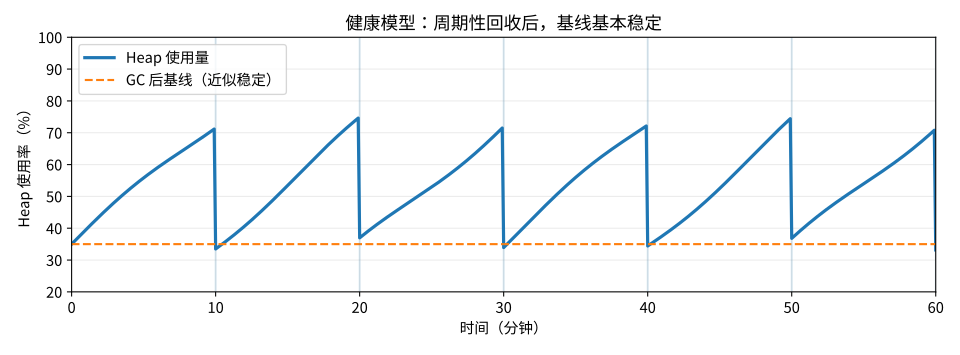
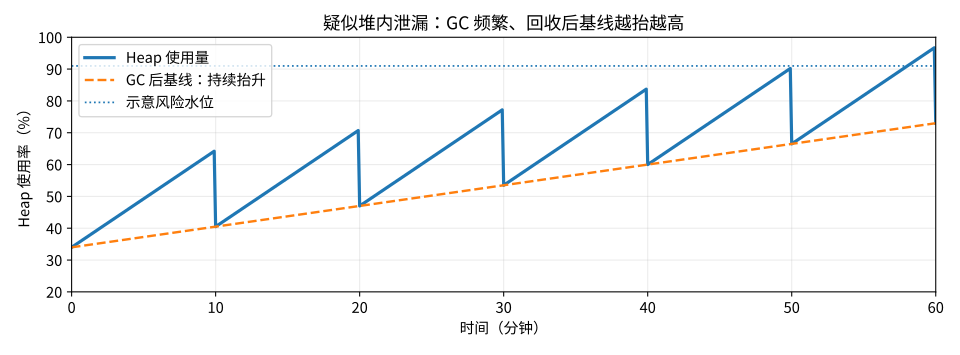
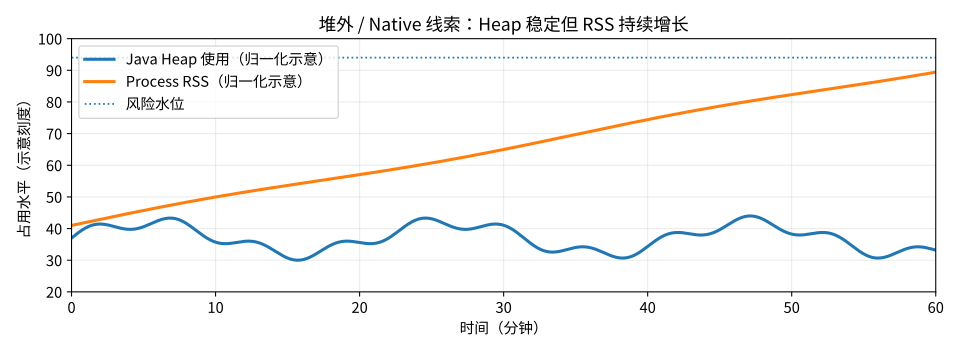
注意: 堆内存的 GC 后基线上升只是“异常线索”,并不自动等于泄漏;还需要排除流量上升、缓存预热和合理数据积累。RSS 背离也不是 Netty 的唯一证据。
5. 七类常见 OOM 与非 Java OOM
| 症状 / 文本 | 主要排查方向 | 第一批证据 |
|---|---|---|
OutOfMemoryError: Java heap space |
堆容量不足、大对象、缓存/集合引用泄漏 | GC 日志、Heap Dump、对象直方图 |
GC overhead limit exceeded |
GC 花费大量时间但回收极少 | GC 日志、Heap Dump、流量指标 |
OutOfMemoryError: Metaspace |
类元数据增长、类加载器不能释放、配额不足 | 类加载计数、jmap -clstats、NMT |
Compressed class space |
压缩类空间不足、动态类过多 | 相关 JVM 参数、类数量、ClassLoader 统计 |
Direct buffer memory / Netty OutOfDirectMemoryError |
Direct Buffer 上限、池化缓冲区未释放、高并发峰值 | RSS、Direct Memory 指标、Netty 泄漏日志 |
unable to create new native thread |
线程数、pids.max、ulimit、剩余 native 内存 |
线程数、thread dump、进程/cgroup 限制 |
Requested array size exceeds VM limit |
单个数组申请超过 VM 支持限制 | 异常栈、数组长度计算、入参 |
容器 OOMKilled / exit code 137 |
cgroup 上限被打穿(可能没有 Java OOM) | cgroup 事件、Pod 描述、RSS/内存曲线 |
强调: OutOfMemoryError 是一个异常类别,不是所有 Java 进程内存问题都表现为这个异常。Java 的 OOM 与 Linux OOM killer 是两个不同层次的事件。
5.1 GC overhead limit exceeded 要怎么理解
在 JDK 8 HotSpot 的典型判据中,GC 长时间占据大量运行时间(约 98%),而回收到的堆空间极少(不到约 2%,连续多轮满足条件)时可能触发。不要把这两个百分比当成普适、跨 GC 实现的固定判据,也不要把禁用 UseGCOverheadLimit 当成根因修复。
5.2 4 GiB 容器、3 GiB Xmx,为什么照样被杀
示例容量账单(演示用,非统一配比):
| 项目 | 假设量级 |
|---|---|
| Java Heap | 3.0 GiB(假设大部分页驻留) |
| Direct/Netty Buffer | 0.55 GiB |
| Metaspace + Code Cache | 0.25 GiB |
| 线程栈、JVM/GC、其他 native | 0.30 GiB |
| 粗略合计 | 4.10 GiB |
即使 Xmx 未超 3 GiB,整体已经有超过 4 GiB 的风险。还要考虑内存统计重叠、页缓存和瞬时峰值,所以不能把这个演示合计当成可精确推算 RSS 的公式。要看系统实测,而不是纸面上只加 Xmx。
6. 生产环境 OOM 排查总流程
6.1 五步法:先定类、后取证、再定位
第一步:先判断“异常是谁抛的、进程是谁杀的”
先看 OutOfMemoryError 完整文本、最后几十秒业务日志、容器退出状态。
# Kubernetes:示例,需替换命名空间与 Pod 名
kubectl -n <namespace> describe pod <pod>
kubectl -n <namespace> logs <pod> --previous --timestamps --tail=300

# Linux cgroup v2(文件路径依实际部署而变化)
cat /sys/fs/cgroup/memory.max
cat /sys/fs/cgroup/memory.current
cat /sys/fs/cgroup/memory.events
注意: 137 常对应进程收到 SIGKILL,容器 OOMKill 是重要原因之一,但并不能单凭退出码 137 就确认 OOMKill;需要事件、容器状态或 cgroup 证据相互印证。
第二步:记录现场,不要先盲目改 Xmx
建议立即记录:JDK 版本、启动 flags、GC 类型、进程/容器内存、线程数、最近发布、流量与错误分布。原则上先止损(摘流、限流、扩容、回滚),并与证据保全并行开展。
第三步:确定该用哪类证据
一句话口诀: 堆问题看 GC + Dump;类元数据问题看 ClassLoader;堆外问题看 Native + RSS;线程问题看线程数 + 系统限制;直接被杀先看 cgroup。
第四步:找“谁持有”或“谁增长”
不要停在“byte[] 占了 60%”这种表象。必须确认:是谁持有它、为什么持有这么久、什么时候应该释放。对于 Heap 问题看 GC Roots 和 Retained Heap;对于 native 问题看时间差、分配来源与所有权。
第五步:通过同负载回归证明修复
“改了代码,不再立刻 OOM”不等于修复成功。至少验证:相同 QPS、相同包大小、相同长连接数、相同运行时长下,GC 后基线、RSS、Direct Memory、类数量、线程数不再无界增长。
6.2 为什么采集 Heap Dump 要谨慎
在 JDK 8 常见 HotSpot 版本里:
# 优先先看支持哪些诊断命令和参数
jcmd "$PID" help GC.heap_dump
jcmd "$PID" help GC.class_histogram

# HPROF:可能高停顿、高磁盘 I/O,并可能引发 Full GC
jcmd "$PID" GC.heap_dump /data/dumps/java-$PID.hprof

# 或采用 JDK 8 常见工具:对堆 dump 也有明显影响
jmap -dump:format=b,file=/data/dumps/java-$PID.hprof "$PID"
生产注意事项:预留足够磁盘空间、确认线程/堆停顿风险、控制取证频率、避免多个实例同时 dump、根据故障紧急程度决定是否先切换流量。jmap -histo:live、部分 jcmd Heap Dump 默认行为可能主动请求 Full GC;不同版本选项不完全相同,一定先看 jcmd <pid> help <command>。
Heap Dump 可能包含姓名、手机号、身份证号、Token、请求报文等敏感信息。按生产敏感数据管理,最小权限传输并按制度清除。
7. 五类典型故障实战
案例 A:堆内泄漏——缓存 / 集合无限增长
现象: 请求量正常但 GC 后 Old 占用持续升高,Full GC 后仍居高不下,最终 Java heap space。
打开 Eclipse MAT 后:
Histogram:按 Shallow Heap 看数量和对象自身内存;看byte[]、String、业务 DTO、集合节点等异常规模。Dominator Tree:按 Retained Heap 排序,观察某个 Map、缓存管理器或 Service 单例间接保留多少内存。Path to GC Roots:找出引用链,比如static INSTANCE → cache → map → entry → byte[]。- 与业务指标核对:请求结束后这些对象是否仍有正当用途?缓存是否设置容量/TTL?是否意外使用无限队列?
非常关键:Shallow vs Retained
- Shallow Heap:当前对象本身占用的内存。
- Retained Heap:当对象失去引用、且由它所支配的对象也因此不可达时,理论上能释放的一整批对象内存。
HashMap 自身不一定大,却可能通过 value 持有大量 byte[]。因此不要只看最靠前的“大数组”就去改 byte[] 的创建语句。
修复方向: 缓存增加 TTL / 最大容量、改分页/流式处理、限制批量返回大小、修正静态集合以及异步任务完成后的引用清理。仅增大 Xmx 通常只是延缓出问题的时间。
案例 B:Netty / Spring Cloud Gateway 堆外内存问题
现象: -Xmx 内的 Heap 很稳定,Old 也不高,但进程 RSS 不断上升;可能出现 Netty OutOfDirectMemoryError、OutOfMemoryError: Direct buffer memory,或者先被容器杀掉。
关键概念:谁拿到 ByteBuf,谁负责生命周期?
ByteBuf 初始引用计数一般是 1;retain() 增加,release() 减少,降到 0 时由其实现释放或归还底层资源。异步传递、切片和聚合要遵守 Netty / 框架约定:谁拥有、谁转移、谁释放。
ByteBuf buf = PooledByteBufAllocator.DEFAULT.directBuffer(1024);
try {
    buf.writeInt(42);
    // 只在当前作用域读取,不把所有权交给其他组件
    consumeSynchronously(buf);
} finally {
    buf.release();
}
上面是自己分配、自己释放的最小示例,不可照搬到所有 channelRead 或 WebFlux 操作符内。若成功把所有权移交给下游(例如框架接管出站写入),再由本层释放就可能 double release。
两种相反的 bug
- 漏释放 / 多余 retain:占用积累,buffer 池无法回收,可能出现堆外耗尽。
- 提前释放 / 重复释放:
IllegalReferenceCountException: refCnt: 0等访问失效问题,常发生在异步链路或手工release与框架自动释放交错时。
# 有疑点时先在测试环境或灰度开启(高档位有性能开销)
-Dio.netty.leakDetection.level=advanced

# 压测时可短期开启,全量跟踪成本很高
-Dio.netty.leakDetection.level=paranoid
观察 LEAK: ByteBuf.release() was not called...,结合 Created at、Recent access records 回溯。注意 Netty 泄漏检测默认常为采样,没有日志不等于没有泄漏。
排查顺序
- 对齐 RSS 与堆占用,看两者是否背离。
- 看 DirectBufferPool 的
MemoryUsed、TotalCapacity等监控(注意这类 MXBean 指标不一定能完整覆盖 Netty 所有 native 分配)。 - 区分 JDK NIO 的
MaxDirectMemorySize路径和 Netty 自身分配/额度逻辑,检查版本及io.netty.maxDirectMemory等配置。 - 对 suspect handler、DataBuffer 转换、
retain、release、slice、异步转交、异常分支逐一标注所有权。 - 在压测/灰度开启 Netty Advanced 泄漏检测,复现相同请求大小与并发连接数。
实践提示: Spring WebFlux 的 DataBuffer 可能包装 Netty 引用计数缓冲区;对 join()、filter 读取 body、异常分支、取消订阅后的资源释放要按框架 API 契约检查,而不能简单地“在哪里看到就释放”。
案例 C:Metaspace 不断增长——动态类与 ClassLoader
现象: 类加载数量持续增加,Metaspace 接近上限,Heap 并不总是很满,可能触发 OutOfMemoryError: Metaspace。
排查重点是到底谁在重复生成/加载类,谁又把对应 ClassLoader 留住了。场景包括热部署、动态代理、脚本引擎、错误的缓存、过度生成代理类、旧版本反射/序列化框架等。
# JDK 8:看当前加载/卸载类累计信息
jstat -class "$PID" 1000 10

# JDK 8:查看类加载器和类元数据占用(可能有明显开销)
jmap -clstats "$PID"

# 结合 NMT 和 JVM flags
jcmd "$PID" VM.flags
jcmd "$PID" VM.native_memory summary scale=MB
特别讨论: 旧环境中曾可能在内存/类统计中出现大量如下类型:
sun.reflect.GeneratedMethodAccessor123
sun.reflect.GeneratedMethodAccessor124
sun.reflect.GeneratedConstructorAccessor125
sun.reflect.DelegatingClassLoader
JDK 8 的反射实现可能在调用达到阈值后生成访问器类。看到这些名字不意味着已经证明 XStream 一定有 bug;应继续比较增长趋势、类加载器数量、代码是否反复创建序列化器实例以及 ClassLoader 生命周期。某些应用将重复创建的解析器复用,可能减少元数据增长;但“改成 static 就一定解决”不是通用结论,仍需检查线程安全、配置共享和并发行为。
修复方向: 避免不必要的动态类生成;复用线程安全且配置稳定的序列化组件;杜绝热部署旧 ClassLoader 被线程、静态注册表、缓存持有;检查代理类和类加载器缓存策略。盲目增大 MaxMetaspaceSize 可能会掩盖泄漏。
案例 D:线程创建失败——不一定是堆不够
典型症状:
java.lang.OutOfMemoryError: unable to create new native thread
重点是线程资源,而不只是 -Xmx。常见原因:无界线程创建、阻塞任务导致线程池膨胀、系统线程数 / PID 限制、容器 pids.max、本地虚拟内存不足。
ps -o pid,rss,vsz,nlwp,cmd -p "$PID"
ps -L -p "$PID" | head -50
cat /proc/"$PID"/status | grep -E 'Threads|VmRSS|VmSize'
cat /sys/fs/cgroup/pids.max 2>/dev/null
ulimit -u
jcmd "$PID" Thread.print > /data/thread-$PID.txt
注意: -Xss1m × 2000 线程 = 2GiB 是用于估算每线程最大栈空间量级的思路,不等于每个线程一创建就立即驻留 1MiB 的 RSS。还受到 guard pages、保留/提交方式、系统线程结构和平台实现影响。
修复方向: 限制线程池上界、排除阻塞/死锁/慢 IO、优化异步模型、检查 PID 约束。简单降低 -Xss 有栈溢出风险,需验证真实调用深度。
案例 E:容器 OOMKilled——没有 Java 堆 OOM
现象: 最后一条日志正常,实例突然重启;没有 HPROF 或 Java 异常,Kubernetes 显示 OOMKilled。
处理顺序:
- 查
kubectl describe pod、事件、cgroupmemory.events(或 v1 对应字段),确认容器内存限制命中。 - 拿 Heap used、进程 RSS、容器内存曲线,同一个时间点对齐。
- 若堆稳定而进程/容器上升,优先考虑 Direct/Netty、Metaspace、线程、JNI/native、文件映射或文件缓存等。
- 若只在流量峰值发生,区分瞬时高峰与长期泄漏;必要时先做限流/背压与更合理的容量预算。
8. 排查命令速查和判读
8.1 低风险优先:先拿线程、flags 和资源快照
# 替换 PID;一般尽量使用同版本 JDK 的工具和相同运行用户
PID=12345

java -version
jcmd "$PID" VM.command_line
jcmd "$PID" VM.flags
jcmd "$PID" GC.heap_info
jcmd "$PID" Thread.print > /data/thread-$PID.txt

# 资源快照
ps -o pid,ppid,rss,vsz,nlwp,%mem,%cpu,cmd -p "$PID"
cat /proc/"$PID"/status | grep -E 'VmRSS|VmHWM|VmSize|Threads'
cat /proc/"$PID"/smaps_rollup 2>/dev/null | head -30
pmap -x "$PID" | tail -5
jcmd GC.heap_info、线程 dump 仍可能触发短暂 safepoint / 较大输出,不要认为诊断命令一律零开销。/proc/*/smaps_rollup 与 cgroup 文件是否存在,取决于 Linux 内核和环境权限。
8.2 堆内:监控 → Histogram → Heap Dump → MAT
jstat -gcutil "$PID" 1000 20
jcmd "$PID" GC.class_histogram > /data/histo-$PID.txt
jcmd "$PID" GC.heap_dump /data/dumps/java-$PID.hprof
选择原则:
jstat:适合观察 GC 趋势,通常开销较低。class_histogram:可以快速识别哪些对象类型占比较大,但有停顿/扫描开销,不建议作为高频监控。heap_dump:信息最全面,但可能有高停顿与很大的磁盘成本;请先通过jcmd PID help GC.heap_dump核实选项和副作用。- Eclipse MAT:Dominator Tree、Leak Suspects、Path to GC Roots。Heap Dump 主要帮助定位堆对象引用链,不能代替 native 追踪。
8.3 Native Memory Tracking(NMT)
NMT 的价值是找 JVM 自身 native 内存分类的变化趋势,不是记录“所有 C 库与 JNI malloc”。
# JVM 启动时开启,已经运行的 JVM 通常无法临时从 off 打开
-XX:NativeMemoryTracking=summary

# 运行后采集
jcmd "$PID" VM.native_memory summary scale=MB
jcmd "$PID" VM.native_memory baseline
# 在等效负载下运行 10~30 分钟后
jcmd "$PID" VM.native_memory summary.diff scale=MB
summary、detail 有性能/内存开销,detail 更大;不同版本可能不完全相同。NMT 追踪 HotSpot/JVM 内部原生内存,不覆盖全部第三方 native 申请。若 NMT 中增长不明显,但 RSS 在涨,应继续查 DirectBuffer、Netty 原生分配、JNI、自定义 malloc、内存映射和内核侧指标。
8.4 Linux / Kubernetes 的证据与风险等级
| 动作 | 目的 | 典型影响 / 风险 |
|---|---|---|
ps、读 /proc、读 cgroup |
内存 / 线程 / OOM 事件 | 通常低,取决于环境 |
jstat -gcutil |
GC 使用趋势 | 通常较低 |
jcmd VM.flags、VM.command_line |
配置 | 通常较低 |
jcmd Thread.print |
阻塞栈、线程数 | 线程很多时输出量较大,有短暂停顿可能 |
jmap -clstats |
类加载器统计 | 中高开销,视版本和类数量 |
jcmd GC.class_histogram |
堆对象类型 | 可能较高,可能影响停顿 |
jcmd GC.heap_dump |
完整堆快照 | 高风险:停顿、磁盘、可能 Full GC |
jmap -F、强制 attach |
非常规恢复 | 高风险:仅确认环境与风险后使用 |
9. JVM 参数、容量预算与预防
9.1 JDK 8 G1 常用基础启动参数示例
以下是一组示例参数,不代表可以不经压测就直接上生产:
-Xms2g
-Xmx2g
-XX:+UseG1GC
-XX:MaxGCPauseMillis=200
-XX:MaxMetaspaceSize=512m
-XX:MaxDirectMemorySize=512m
-Xss1m
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/data/dumps
-XX:+PrintGCDetails
-XX:+PrintGCDateStamps
-Xloggc:/data/logs/gc.log
-XX:+UseGCLogFileRotation
-XX:NumberOfGCLogFiles=5
-XX:GCLogFileSize=20M
特别注意:
MaxGCPauseMillis是目标,不是保证。MaxDirectMemorySize不必然完全约束 Netty 所有原生内存路径,需结合版本和 Netty 参数。Xms = Xmx有利于稳定堆容量/避免部分扩容成本,但也会改变初始内存足迹和弹性,不是所有容器都适用。- JDK 8 GC 日志选项与 JDK 9+ 统一日志格式不同。JDK 11/17+ 应使用
-Xlog:gc*...等新语法。 - JDK 8 早期更新版本的容器感知能力存在差异;必须核对具体
8u版本和实际VM.flags,不要假设所有 JDK 8 都能自动正确识别 cgroup 限制。
9.2 计算容量时要留出 native 空间
一种稳妥的预算方法是先拆分:
容器内存额度
  ├── Java Heap 可驻留内存(受 Xmx 上界影响)
  ├── Direct / Netty / JNI 等堆外开销
  ├── Metaspace 与 Compressed Class Space 的已提交部分
  ├── JIT Code Cache、GC、自身 native 开销
  ├── 线程栈和本地线程开销
  └── 文件页缓存 / 突发峰值 / 安全余量
没有一个对所有 JVM 服务都适用的 Xmx = container limit × 75% 黄金比例。应在真实峰值下测量上述指标和高水位,再决定容器限制和 Xmx。特别是网关、文件上传下载、图片/PDF 处理、JNI 调用密集型服务,其 native 预算可能显著高于普通 CRUD 服务。
9.3 应该建立哪些常态化监控
建议至少包含:
- Heap used / committed / max、Old 使用率、GC 后基线。
- Young/Full/Mixed GC 次数、停顿时长、GC 总耗时占比。
- Metaspace used/committed、loaded class count、unloaded class count。
- Direct Buffer pool 指标、Netty allocator/pool 使用情况(按可用监控接口)。
- Process RSS、容器
memory.current/ 工作集(需统一口径)、容器 OOM 事件。 - 线程数、线程池 active/queue、EventLoop 排队/阻塞。
- QPS、响应报文大小、上传下载吞吐、错误率、最近发布批次。
告警不要只设一个堆百分比阈值。 例如“GC 后 Old 持续上升 + RSS 上升 + 相同 QPS + 类数量稳定”比单纯 Heap 80% 更有诊断价值。
9.4 JDK 8 与 JDK 17+ 排查差别速览
| 主题 | JDK 8 HotSpot | JDK 17+ HotSpot(视实现/版本) |
|---|---|---|
| 默认 GC | 依环境、JDK 版本与 ergonomics 确定,常见 Parallel GC | 常见默认 G1,但应以实际 flags 为准 |
| GC 日志 | -XX:+PrintGCDetails、-Xloggc |
-Xlog:gc* 等统一日志 |
| 反射访问器实现 | 常见 sun.reflect.GeneratedMethodAccessor 等 |
JDK 18 后核心反射逐步改基于 MethodHandle;诊断表现不同 |
| Metaspace | JDK 8 已存在 | 仍存在,内部实现有变化 |
| native / 容器行为 | 早期 8u 容器支持需核对 | 容器支持更成熟,但仍需核对 JVM/部署 |
| dump / NMT / MAT 思路 | 适用 | 适用,但参数与工具选项可能变化 |
10. 排查清单、自查问题与参考资料
10.1 阅读路线
| 顺序 | 内容 | 相关图 |
|---|---|---|
| 01 | 从 JVM 进程全貌与内存边界开始 | 图 01、11 |
| 02 | 理解 Heap、Stack、Metaspace 与对象布局 | 图 02、03、04、15 |
| 03 | 梳理对象分配、分代与 G1 Region | 图 05、06、07 |
| 04 | 结合 GC Roots、G1 周期和日志判断回收效果 | 图 08、09、19 |
| 05 | 按 OOM 类型建立现场排查路径 | 图 10、12、18、20 |
| 06 | 深入 Heap Dump、Netty、Metaspace 等典型案例 | 图 13、14、15、17 |
| 07 | 使用检查清单和自查问题回顾 | 本节 |
10.2 一页应急 SOP(可复制进团队 Runbook)
[ ] 1. 确认故障:Java OOM 文字?容器 OOMKilled?线程创建失败?
[ ] 2. 确认环境:JDK 版本、GC、Xmx、Direct、Meta、容器限制。
[ ] 3. 保存时间线:最近发布、QPS、错误、Heap、GC、RSS、线程数。
[ ] 4. 止损:摘流/限流/扩容/回滚;评估保留现场的风险。
[ ] 5. 分流证据:Heap → GC + HPROF;Meta → ClassLoader;
           Direct/native → NMT + RSS + Netty;线程 → dump + pids。
[ ] 6. 判断链路:谁持有对象?谁生成类?谁分配 buffer?谁创建线程?
[ ] 7. 复现并修复:相同流量、相同包大小、相同连接数、长稳压测。
[ ] 8. 验证修复:GC 后基线稳定、RSS 不再无界增长、无异常增量。
[ ] 9. 沉淀:监控告警、预置取证权限、灰度配置、复盘和防再发。
10.3 自查问题与分析要点
-Xmx4g是否意味着 Java 进程至多使用 4G? 否;还有 Metaspace、栈、Direct、JNI、Code Cache 等。- 对象
new一定立刻分配到 Heap Eden 吗? 不一定;JIT 可能消除分配,G1 Humongous 等存在特殊路径。 - G1 的一个 Region 里同时有 Eden 和 Old 吗? Region 作为逻辑角色单位,某时刻按 Region 分配角色,不是每个 Region 内各划一块。
- GC 后老年代不降就是泄漏吗? 不一定;可能是合理长期存活对象,需业务语义和增长趋势验证。
byte[]数量最多,就说明创建byte[]的地方是根因吗? 不一定;应查 Retained Heap、引用链、持有者。OutOfDirectMemoryError应先做 Heap Dump 吗? 不是第一选择;应先核查 RSS、Direct、Netty 池与引用计数。sun.reflect.GeneratedMethodAccessor多,能否直接断定 XStream 的问题? 不能;必须结合反射/动态类趋势、ClassLoader 和创建模式。ThreadLocal.remove()为什么重要? 池化线程可能长寿,ThreadLocalMap 的 value 仍可能被线程间接保留;请求范围数据需及时清理。- 容器进程退出码 137 能否直接确定是 OOMKilled? 不能;需事件与 cgroup 证据。
- 发现问题后为什么不直接调大内存? 需要区分容量不足、无界增长、流量峰值、算法问题;盲目加内存可能只延迟复发。
10.4 五条排查原则
- 先识别内存类型,再选工具,不要所有 OOM 都导 Heap Dump。
- 看增长趋势比看单次占用更重要,尤其是 GC 后基线。
- Heap 泄漏看引用链,Native 泄漏看分配与释放责任。
- Xmx 不是 Java 进程的上限,容器预算必须覆盖 native 和峰值。
- 排查的终点不是调参数,而是能解释根因并通过相同负载验证。
10.5 参考资料与进一步阅读
文中的图均为教学示意,不是直接从官方文档复制的内存布局图。参数、不同版本 GC 实现、日志和诊断命令,请以现场 JVM 实际输出和以下资料为准。
- Oracle JDK 8 Troubleshooting Guide — Understand the OutOfMemoryError Exception
- Oracle JDK 8 — G1 Garbage Collector Tuning
- Oracle — Getting Started with the G1 Garbage Collector
- Oracle — Native Memory Tracking
- Oracle JDK 8 — The jmap Utility
- Netty — Reference counted objects
- Eclipse MAT — Finding Memory Leak
- Eclipse MAT — Dominator Tree
阅读说明:文中23张示意图与趋势图以SVG矢量图提供,页面包含完整图像资源。
先记住这几件事
- Java进程内存不等于Heap,Xmx也不是进程或容器的内存上限。
- 先按异常文本和容器事件区分Heap、Metaspace、Direct、线程与OOMKilled。
- Heap问题看GC趋势、Heap Dump与GC Roots;Native问题结合RSS、NMT和分配所有权。
- 诊断命令有停顿、CPU和磁盘代价,先评估风险并保留现场。
- 修复后在相同流量与负载下复测GC后基线、RSS、Direct Memory、类数量和线程数。